论文精读|TAO:面向 LLM Agent 服务的工具感知联合调度
Agent 会话有九成以上的时间在等 CPU 上的工具调用。TAO 用一个按字典序比较的三元组给等待中的会话估值,再用多背包动态规划一次性决定谁上 GPU、上哪台。这篇精读按论文原始数据复现了关键图表,也标出了它没赢的地方。
论文:TAO: Tool-Aware Joint Scheduling for LLM-Based Agentic Serving(arXiv.37230v1,2026 年 10 月) 作者:Shuhuai Li、Shengdong Ye、Dongdong Ge、Jianghao Lin(上海交通大学),Yinyu Ye(斯坦福大学) 许可:CC BY 4.0。文中图 1、图 2 直接引用原图;其余图表由我按论文表格和原图矢量坐标重绘。
一句话
Agent 会话在 GPU 推理和 CPU 工具调用之间来回切换,现有调度器挑会话时既不知道工具什么时候返回,又是一个一个贪心地放。TAO 把"缓存信用、工具是否就绪、上下文长度"按固定优先级排成三元组,再在节点容量约束下对整个等待池做一次动态规划。在论文报告的 12 组设置里,相对每项指标上最好的基线,端到端延迟最多降 26.8%,平均 TTFT 最多降 36.3%,解码吞吐最多升 29.5%。
"最多"两个字要留意:同一组表格里也有 TAO 落后的格子,第 6 节会列出来。
1. 问题:工具调用把推理切成了碎片
SWE-agent、Claude Code 这类 Agent 的一个任务由多轮组成:模型生成工具调用,交给外部 CPU 环境执行(跑测试、编译、检索),拿到结果拼回上下文,再请求下一轮推理。论文把这种部署叫 CGDC(Clustered GPUs with Distributed CPUs):GPU 节点集中提供推理,工具在独立的 CPU/内存预算上运行。
论文图 1 左下角的条形图给了一个数:在他们的负载里,工具调用占了端到端时间的 93.1%,推理只占 6.9%。既然大部分时间 GPU 用不上,调度器就可以在工具边界做会话中断,释放该会话的准入额度,把它放进等待池;工具返回后再做会话重启,挑一个节点重新准入。这套生命周期沿用自 ThunderAgent(Kang et al., 2026),TAO 关注的是"从等待池里挑谁、放哪"。
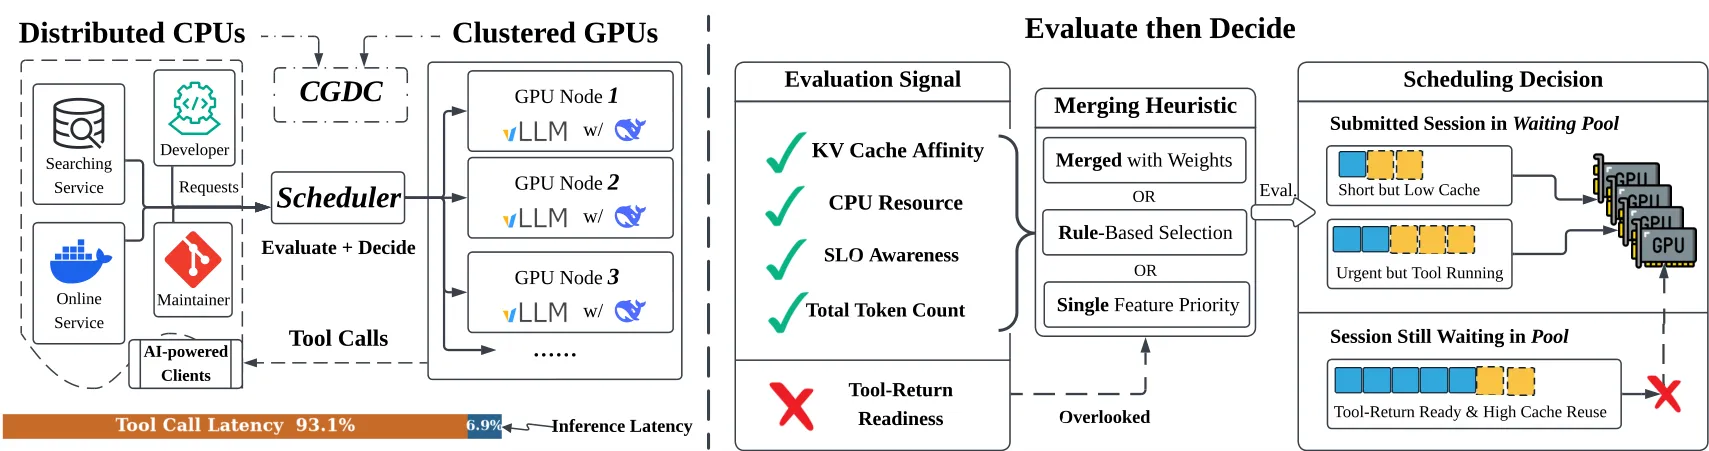
现有系统(llm-d、SGLang、Dynamo、ThunderAgent 等)大体是"先评估、后决策",论文认为两步各有一个缺口:
- 评估:看 KV Cache 亲和性、Token 数、SLO,但不看工具什么时候返回;多个特征靠手调的加权或阈值合成一个分数。
- 决策:每个会话单独打分、单独路由。几个"短但缓存命中低"的会话可能先占掉容量,把"工具已返回、缓存命中高"的会话挡在外面。
2. 方法总览:用三元组代替加权和
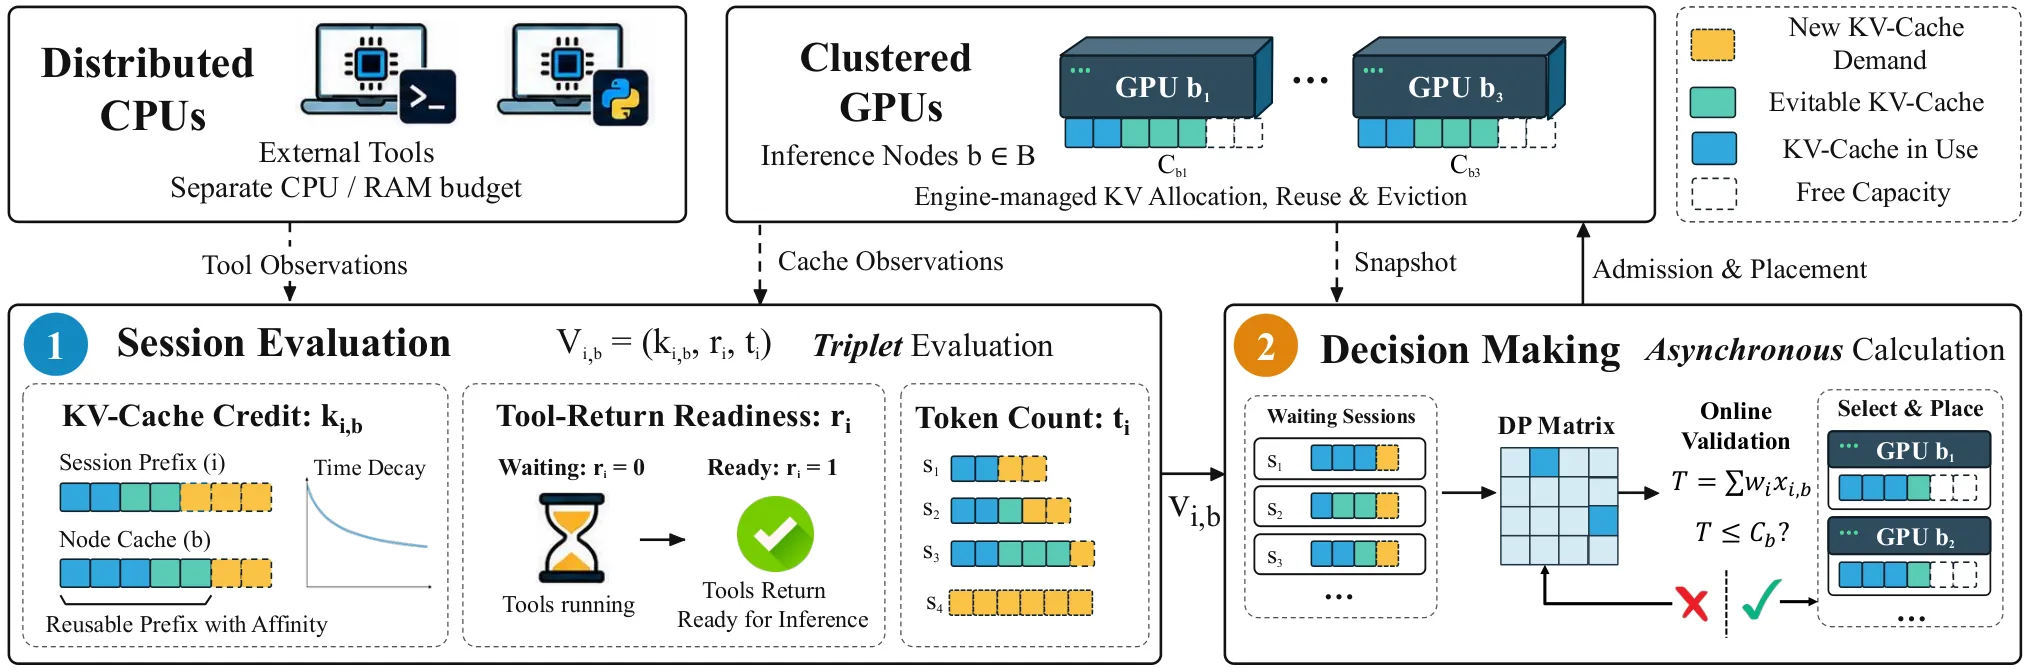
设等待池为 (被中断的会话加新到达的会话),快照里的 GPU 节点集合为 。会话 的准入成本是 ,节点 的剩余容量是 , 是允许的会话-节点对。可行域是:
每个可行的会话-节点对得到一个三元组,目标是按字典序最大化选中三元组之和:
三个分量的优先级是固定的:
- ,衰减后的缓存信用。命中前缀直接省掉 Prefill,所以排第一;但它随暂停时间快速衰减。
- ,工具返回就绪度。第一项衰减到打平之后,由它区分"马上要回来"和"还早"的会话。
- ,累积 Token 数。前两项都打平时偏向上下文更长的会话;它占的容量更大,这笔账由后面的 DP 去算。
用字典序而不用加权和,好处是不用调权重:不同量纲的特征不会互相抵消。代价是表达力变窄,第一项只要差一点点,后两项就完全不起作用。TAO 靠下一节的衰减和取整来缓解这一点。
3. 两个信号:缓存信用怎么衰减,工具什么时候回来
3.1 缓存信用的时间衰减
会话因工具调用暂停时,它在节点 上留下的前缀不会一直在:其他请求在跑,引擎会按自己的策略驱逐 KV 块。论文在 DeepSeek-V4 Flash(2 节点 × 4 H100)的轨迹上统计了"暂停多久之后,下一次请求还能命中多少缓存",也就是图 3。
数据点按论文原图的矢量坐标还原。拖动滑块只改变调度器的折算曲线,不改变实测数据。
TAO 对观测到的缓存信用 按暂停时长打折,并对结果取整:
论文取 秒。这里有一个容易读错的地方: 不是对缓存保留率的拟合。论文明确说半衰期是调度参数,和轨迹拟合出的时间常数是两回事。对比一下就清楚了:暂停 44 秒时实测中位数还有 91.4%,而 的信用只剩 。
我的理解是,衰减在这里的作用主要是让出优先级:信用很快被压低、取整后打平,第二项 才有机会起作用。滑块拉到 60 秒能看到,衰减变慢后,第一项会在更长时间里独占排序。论文没有报告 的敏感性实验,取 10 秒是怎么定的,正文没有交代。
另外,图 3 的中位数不是平滑下降的:44 秒以内都在 90% 以上,87 秒之后直接归零,中间那两个分箱的 95% 区间覆盖了 0 到 96%。"指数衰减"是描述性拟合,真实形状更像一个阈值。
3.2 工具返回就绪度
TAO 要回答"这个会话的工具会不会在接下来 秒内返回"。论文取 秒,和调度周期一致。信号按可信度依次取:
- 工具接口直接暴露的进度或截止时间,例如 Claude Code 的 Monitor 事件、OpenCode 的 Bash 超时信息;
- 从命令里解析出的
sleep N; - 按结构化工具名统计的历史耗时;没有该工具的历史就用全局历史,再没有就用 5 秒默认值。
历史估计用了一个经验 Bernstein 形式的保守上界(附录 A,Maurer & Pontil 2009),:
减去已执行时间 得到剩余时间 。二元信号 的规则是:
- 工具已经完成,直接置 1,优先于任何预测;
- 预测完成时间落在 以内,且预测时间戳在 30 秒内刷新过,置 1;
- 预测时间已过但工具还没回来,只给一个临时的探针机会,不会一直占着"就绪"。
论文自己也说,这个上界是调度启发式,不保证单次调用的覆盖率。实际效果看附录数据:在 10,967 次完成的工具调用上,最终预测的平均绝对误差是 0.410 秒,82.9% 的误差在 0.5 秒以内,也就是半个调度周期。
4. 决策:多背包动态规划,加一层异步
4.1 为什么贪心不够
拿到每个会话-节点对的三元组后,最直接的做法是按分数从高到低往节点里塞。问题在于各会话的 差别很大,缓存命中又强烈依赖节点。局部看合理的一步,可能把一个节点的剩余空间切碎,或者占掉某个只在特定节点上有大量缓存的会话的位置。附录 H 给了两个重建的真实快照,下面按原图坐标重画。
浅色是会话占用的准入权重,深色是其中能复用的缓存。同一个会话在两种方案里颜色相同。
图 10 里,贪心先把较短的 P89、P123 放进 Node 1,于是 P109(在 Node 1 上有 8.8k 命中)和 P111(6.6k 命中)只能去没有缓存的 Node 2。DP 反过来安排,两边总的剩余安全空间相同,缓存信用从 13,624 增加到 16,791,多 23.2%。
方块宽度是准入权重(含每会话 512 token 预留)。虚线框是没能准入的会话。
图 11 是准入数量的例子。贪心先把四个短会话塞进 Node 1,两个节点各剩约 14k 和 15k,都放不下约 21k 的会话 177,只准入 6 个;DP 把 195、193 挪到 Node 2,在 Node 1 腾出整块空间,准入 7 个。
这两张图是精选的例子。论文第 4.3 节给了更全面的统计:在 23 个有多个候选会话的快照里,DP 在 6 个(26.1%)上改进了字典序目标,其余 17 个和贪心结果相同;算上单候选的情况,35 个快照里改进了 6 个(17.1%)。多数时候 DP 和贪心给出同一个答案,差距来自少数快照。
4.2 动态规划
令 为容量量子,离散化后会话成本 ,节点容量 。 表示只考虑前 个会话、各节点已用容量为向量 时能达到的最大字典序价值:
状态是多维的,节点一多就会爆。论文的两个工程处理:缓存等价的节点合并成 个容量维度;设状态预算,超了就退回 BFD(best-fit-decreasing)。
4.3 异步求解与重验证
为了不阻塞调度主循环,DP 在独立的异步 worker 里对时刻 的冻结快照求解,得到计划 。在时刻 应用前做重验证:被选中会话的状态签名变了就丢弃整个计划;否则只应用当前实时容量允许的最长可行前缀 。
论文给了相对于"在 时刻重新求最优"的损失上界:
是可行域变化带来的新机会, 是规划期间的价值漂移, 是重验证截断造成的损失。这个界是有条件的:若每个计划最多 个分配、单个分配的价值漂移有界,并进一步假设漂移随时间线性增长 ,漂移项才变成 。论文特别指出,二元就绪度的跳变不满足这个假设,需要单独留余量。所以它更适合理解为"规划越新鲜,损失越小"的定性保证,而不是可以直接代入的数。
开销数据在附录 Table 9。我把它摘成下表,因为原 HTML 里"单次 DP 仅需 0.551.59 ms""回退仅 3%8%"的说法只取了部分列:
| 设置 | Workers | 求解均值 | 求解 P95 | 调度工作占运行时间 | BFD 回退 | 计划丢弃 |
|---|---|---|---|---|---|---|
| DeepSeek-V4 Flash,TP4 × 2 | 16 | 0.55 ms | 0.55 ms | < 0.001% | 0% | 0% |
| 32 | 1.48 ms | 2.08 ms | 0.005% | 0% | 0% | |
| 64 | 12.50 ms | 88.84 ms | 0.297% | 5.24% | 0.37% | |
| Qwen3-32B,TP2 × 4 | 96 | 0.56 ms | 0.62 ms | 0.003% | 3.06% | 0% |
| 128 | 1.04 ms | 2.43 ms | 0.077% | 6.74% | 0.14% | |
| 160 | 1.59 ms | 3.68 ms | 0.112% | 8.98% | 0.18% |
摘要里"低于运行时间 0.12%"指的是 Qwen 四副本那一组。DeepSeek 64 workers 时求解均值到了 12.5 ms,P95 接近 90 ms,调度工作占比约 0.3%,仍然很小,但已经不是"亚毫秒"。并发越高,回退到 BFD 的比例也越高。
5. 实验设置
- 模型与硬件:DeepSeek-V4 Flash(2 节点 × 4 H100),Qwen3-32B(4 节点 × 2 H100,4 副本),GLM-4.7(单节点 8 × H100,TP8)。
- 负载:SWE-bench Lite(SWE-Lite,用 mini-SWE-agent 驱动);DeepSeek 另跑 Terminal-Bench 2.0(用 Claude Code 驱动);Qwen 与 GLM 另跑 SWE-verified。GLM 每次运行 300 个任务。
- 基线:Dynamo(KV 感知调度)、vLLM 调度器配 Round-Robin(RR)或 Cache-Aware(CA)路由、ThunderAgent(按 Token 数排序 + BFD 放置)。
- 指标:任务端到端平均延迟、平均 TTFT、解码吞吐。
6. 主要结果
下表是论文 Table 1 和 Table 2 的全部数据,每列最好的值加粗,最后一行是 TAO 相对该列最优基线的变化,负值标红。
DeepSeek-V4 Flash · SWE-Lite2 nodes with 4 × 4\times H100 per node
| 调度器 | 16 workers | 32 workers | 64 workers | ||||||
|---|---|---|---|---|---|---|---|---|---|
| Latency (s) ↓ | TTFT (s) ↓ | Decode (tok/s) ↑ | Latency (s) ↓ | TTFT (s) ↓ | Decode (tok/s) ↑ | Latency (s) ↓ | TTFT (s) ↓ | Decode (tok/s) ↑ | |
| Dynamo | 122.0 | 0.146 | 874.1 | 152.3 | 0.176 | 1393.3 | 269.8 | 0.351 | 1548.5 |
| vLLM Scheduler w/ RR | 122.8 | 0.177 | 888.5 | 158.8 | 0.217 | 1145.6 | 290.7 | 0.508 | 1299.8 |
| vLLM Scheduler w/ CA | 116.0 | 0.183 | 889.6 | 150.4 | 0.226 | 1256.1 | 253.2 | 0.410 | 1561.3 |
| ThunderAgent | 123.6 | 0.379 | 796.2 | 215.7 | 2.708 | 961.8 | 407.2 | 7.447 | 969.0 |
| TAO (Ours) | 113.3 | 0.135 | 935.0 | 142.3 | 0.153 | 1477.5 | 185.4 | 0.224 | 2021.5 |
| 相对最优基线 | +2.4% | +7.4% | +5.1% | +5.4% | +13.3% | +6.0% | +26.8% | +36.3% | +29.5% |
DeepSeek-V4 Flash · Terminal-Bench2 nodes with 4 × 4\times H100 per node
| 调度器 | 16 workers | 32 workers | 64 workers | ||||||
|---|---|---|---|---|---|---|---|---|---|
| Latency (s) ↓ | TTFT (s) ↓ | Decode (tok/s) ↑ | Latency (s) ↓ | TTFT (s) ↓ | Decode (tok/s) ↑ | Latency (s) ↓ | TTFT (s) ↓ | Decode (tok/s) ↑ | |
| Dynamo | 536.6 | 1.371 | 494.9 | 579.6 | 1.252 | 651.2 | 688.5 | 1.315 | 760.7 |
| vLLM Scheduler w/ RR | 342.5 | 0.306 | 820.8 | 375.2 | 0.499 | 1071.1 | 467.4 | 0.582 | 1597.5 |
| vLLM Scheduler w/ CA | 304.8 | 0.319 | 723.9 | 394.7 | 0.331 | 1146.4 | 393.1 | 0.387 | 1654.1 |
| ThunderAgent | 361.1 | 0.336 | 876.1 | 380.1 | 1.402 | 1053.0 | 391.6 | 1.010 | 1376.5 |
| TAO (Ours) | 298.2 | 0.239 | 798.6 | 333.6 | 0.264 | 1161.4 | 376.6 | 0.324 | 1551.4 |
| 相对最优基线 | +2.2% | +21.7% | -8.8% | +11.1% | +20.3% | +1.3% | +3.8% | +16.2% | -6.2% |
Qwen3-32B · SWE-Lite4 nodes with 2 × 2\times H100 per node
| 调度器 | 96 workers | 128 workers | 160 workers | ||||||
|---|---|---|---|---|---|---|---|---|---|
| Latency (s) ↓ | TTFT (s) ↓ | Decode (tok/s) ↑ | Latency (s) ↓ | TTFT (s) ↓ | Decode (tok/s) ↑ | Latency (s) ↓ | TTFT (s) ↓ | Decode (tok/s) ↑ | |
| Dynamo | 821.6 | 2.098 | 2074.6 | 857.4 | 7.924 | 1203.7 | 1203.7 | 17.208 | 1239.4 |
| vLLM Scheduler w/ RR | 775.3 | 5.109 | 1400.6 | 975.4 | 11.179 | 1359.8 | 1088.0 | 16.645 | 1433.3 |
| vLLM Scheduler w/ CA | 811.6 | 5.339 | 1614.7 | 881.1 | 11.707 | 1456.4 | 1179.3 | 18.304 | 1285.4 |
| ThunderAgent | 716.3 | 2.051 | 2104.9 | 839.3 | 8.705 | 2036.3 | 1028.5 | 16.209 | 1712.4 |
| TAO (Ours) | 634.7 | 1.827 | 1996.8 | 829.4 | 7.907 | 2051.8 | 1031.0 | 14.554 | 1827.6 |
| 相对最优基线 | +11.4% | +10.9% | -5.1% | +1.2% | +0.2% | +0.8% | -0.2% | +10.2% | +6.7% |
Qwen3-32B · SWE-verified4 nodes with 2 × 2\times H100 per node
| 调度器 | 96 workers | 128 workers | 160 workers | ||||||
|---|---|---|---|---|---|---|---|---|---|
| Latency (s) ↓ | TTFT (s) ↓ | Decode (tok/s) ↑ | Latency (s) ↓ | TTFT (s) ↓ | Decode (tok/s) ↑ | Latency (s) ↓ | TTFT (s) ↓ | Decode (tok/s) ↑ | |
| Dynamo | 736.8 | 1.985 | 1862.8 | 1041.9 | 10.441 | 1820.9 | 1286.2 | 22.469 | 1667.8 |
| vLLM Scheduler w/ RR | 777.6 | 5.082 | 1931.3 | 933.3 | 12.586 | 1804.5 | 1244.5 | 24.221 | 1091.0 |
| vLLM Scheduler w/ CA | 816.2 | 5.731 | 1522.6 | 1016.5 | 14.263 | 1670.9 | 1264.4 | 23.199 | 1619.8 |
| ThunderAgent | 699.8 | 2.396 | 2184.9 | 911.1 | 10.500 | 2045.9 | 1202.2 | 21.608 | 1993.6 |
| TAO (Ours) | 642.0 | 1.392 | 2354.7 | 933.7 | 9.092 | 2128.6 | 1094.3 | 17.619 | 2087.2 |
| 相对最优基线 | +8.3% | +29.9% | +7.8% | -2.5% | +12.9% | +4.0% | +9.0% | +18.5% | +4.7% |
GLM-4.7 · SWE-Liteone node with 8 × 8\times H100 (TP8)
| 调度器 | 96 workers | 128 workers | 160 workers | ||||||
|---|---|---|---|---|---|---|---|---|---|
| Latency (s) ↓ | TTFT (s) ↓ | Decode (tok/s) ↑ | Latency (s) ↓ | TTFT (s) ↓ | Decode (tok/s) ↑ | Latency (s) ↓ | TTFT (s) ↓ | Decode (tok/s) ↑ | |
| Dynamo | 2870.3 | 21.677 | 290.5 | 3779.2 | 41.865 | 287.8 | 4786.7 | 59.548 | 262.2 |
| vLLM Scheduler w/ RR | 2687.8 | 20.927 | 310.8 | 3633.8 | 39.502 | 294.6 | 4391.0 | 53.588 | 272.5 |
| vLLM Scheduler w/ CA | 2606.5 | 19.553 | 318.7 | 3435.8 | 37.665 | 308.0 | 4314.5 | 56.326 | 297.3 |
| ThunderAgent | 999.6 | 7.014 | 773.3 | 1360.4 | 14.243 | 731.1 | 1747.0 | 23.345 | 668.9 |
| TAO (Ours) | 887.7 | 6.777 | 869.6 | 1261.9 | 14.103 | 813.7 | 1476.2 | 20.066 | 805.9 |
| 相对最优基线 | +11.2% | +3.4% | +12.5% | +7.2% | +1.0% | +11.3% | +15.5% | +14.1% | +20.5% |
GLM-4.7 · SWE-verifiedone node with 8 × 8\times H100 (TP8)
| 调度器 | 96 workers | 128 workers | 160 workers | ||||||
|---|---|---|---|---|---|---|---|---|---|
| Latency (s) ↓ | TTFT (s) ↓ | Decode (tok/s) ↑ | Latency (s) ↓ | TTFT (s) ↓ | Decode (tok/s) ↑ | Latency (s) ↓ | TTFT (s) ↓ | Decode (tok/s) ↑ | |
| Dynamo | 3164.6 | 26.761 | 286.2 | 4545.3 | 52.588 | 256.6 | 8217.1 | 86.008 | 163.6 |
| vLLM Scheduler w/ RR | 2938.2 | 23.967 | 292.7 | 4136.0 | 47.930 | 269.8 | 6149.5 | 71.452 | 214.6 |
| vLLM Scheduler w/ CA | 2928.6 | 24.505 | 300.3 | 3935.7 | 46.963 | 284.9 | 5989.5 | 71.239 | 220.9 |
| ThunderAgent | 1146.1 | 12.590 | 691.5 | 1533.3 | 18.516 | 688.3 | 1846.5 | 26.045 | 683.6 |
| TAO (Ours) | 951.7 | 7.752 | 856.8 | 1243.9 | 15.281 | 858.1 | 1548.3 | 21.943 | 839.1 |
| 相对最优基线 | +17.0% | +38.4% | +23.9% | +18.9% | +17.5% | +24.7% | +16.2% | +15.7% | +22.8% |
几点我觉得值得单独说:
- 26.8% / 36.3% / 29.5% 来自同一格:DeepSeek-V4 Flash、SWE-Lite、64 workers。这一格的对照是各列最好的基线:延迟和吞吐比的是 vLLM w/ CA,TTFT 比的是 Dynamo。同一行 16 workers 时,三项只有 2.4%、7.4%、5.1%。
- TAO 不是每格都赢。54 格里有 5 格落后:Terminal-Bench 16 和 64 workers 的解码吞吐分别低 8.8% 和 6.2%;Qwen SWE-Lite 96 workers 的解码吞吐低 5.1%、160 workers 的延迟高 0.2%;Qwen SWE-verified 128 workers 的延迟高 2.5%。论文正文点名了最后一处。
- GLM-4.7 上传统基线差很多:Dynamo 与两个 vLLM 配置的延迟是 TAO 的 2.7 到 5.3 倍。这一组里真正可比的是 ThunderAgent:在 SWE-verified 上,TAO 相对它延迟降 16.2–18.9%、TTFT 降 15.7–38.4%、吞吐升 22.8–24.7%;在 SWE-Lite 上幅度小一些,TTFT 在 128 workers 时只降了 1.0%。
图 4 是 GLM-4.7 在 SWE-Lite、160 workers 下的运行过程:
曲线从论文原图的矢量路径提取后做了简化(容差约 1 个请求)。完成时间取自原图图例。点击图例可隐藏或显示对应曲线。
TAO 在 60.0 分钟跑完全部任务,ThunderAgent 70.9 分钟,其余三个基线在 164 到 189 分钟之间。按论文的解释,区别在中段:TAO 在有限容量下持续、平稳地准入新会话,并发维持在约 40 到 75;ThunderAgent 在约 1,970 秒处从 28 个运行中请求跳到 122 个,之后才回落。
论文附录 D 也提醒,这些曲线是自然运行的结果,各次运行生成的轨迹不同。我在正文和附录里没有找到主表的重复次数或方差,所以个位数百分比的差异要谨慎看待。
7. 消融:哪个组件贡献最大
Table 4,DeepSeek-V4 Flash、SWE-Lite、32 workers:
| 配置 | 解码吞吐 (tok/s) | 缓存命中 | TTFT 均值 | 工具返回到首 Token | 暂停等待 |
|---|---|---|---|---|---|
| 完整 TAO | 1417.97 | 96.31% | 0.154 s | 0.203 s | 0.972 s |
| 去掉缓存信用 | 1398.35 | 96.24% | 0.157 s | 0.209 s | 1.028 s |
| 去掉就绪度 | 1363.06 | 96.16% | 0.161 s | 0.227 s | 1.067 s |
| 两者都去掉 | 1373.51 | 96.24% | 0.182 s | 0.213 s | 1.025 s |
| 用 ThunderAgent 的暂停排序 | 1355.20 | 96.20% | 0.162 s | 0.226 s | 1.025 s |
| 用 BFD 代替 DP | 1233.72 | 96.05% | 0.195 s | 0.235 s | 1.081 s |
- DP 的贡献最大:换成 BFD,吞吐下降 13.0%,TTFT 从 0.154 秒升到 0.195 秒。
- 缓存信用的衰减贡献很小:吞吐只差 1.4%,命中率只差 0.07 个百分点。
- 两项都去掉,吞吐反而比只去掉就绪度高一点(1373.51 对 1363.06),TTFT 则更差。论文没有解释,这类差距可能就在运行噪声范围内。
附录 G 加长了工具返回时延(额外 1–5 秒、2–10 秒、4–20 秒)。时延越长,就绪度改变 DP 计划的比例越高:从 1.65% 升到 3.94%,再到 7.93%。用回放里已知的真实耗时代替历史预测(Oracle),在 2 倍时延时 makespan 只再降 2.24%,说明历史预测已经足够好。不过这组实验每格只跑了一次,论文自己也注明了是探索性的。
8. 我的看法
值得借鉴的地方
- 字典序加衰减,用来代替手调权重。很多网关路由写成
score = w1 * cache + w2 * load + w3 * wait,换个负载权重就得重调。TAO 用固定优先级,让第一项随时间衰减、取整后打平,把排序权自然交给第二项。思路简单,可以直接搬到别的多信号调度里。 - "异步求解快照 + 应用前校验 + 截取可行前缀 + 超时回退"这套组合,是把精确组合优化放进在线调度的一个稳妥做法。表里能看到它的代价:并发上去后回退率到了 9%,但不会卡住主循环。
- 和 Agentic RL 的 rollout 很像。多轮 Agent RL 的 rollout 阶段本身就是 CGDC:大量轨迹卡在容器编译和单测上。把就绪度和联合准入放进 RL 框架的 rollout 调度器,可能缓解长尾轨迹拖慢整个 step 的问题。这是我的推测,论文没有做 RL 场景的实验。
需要留意的地方
- 收益集中在高并发、容量紧张的设置;低并发时和最强基线只差几个百分点,个别格子还落后。
- 消融显示主要收益来自 DP 放置,而第 4.3 节统计 DP 只在约四分之一的多候选快照里改变了结果。两者合起来看,收益来自少数关键决策,这也解释了为什么低并发时差距很小。
- 秒、 秒、 这些参数都是给定值,没有敏感性分析;主表也没有方差。